Новости искусственного интеллекта и технологий
  • Новости
  • Обзор сервисов
  • ИИ в искусстве
  • ИИ в бизнесе
  • ИИ в науке
  • ИИ в жизни
Автор

admin

admin

ИИ в бизнесеИИ в искусствеИИ в науке

Стратегия искусственного интеллекта Microsoft окупается с ростом доходов от твердого облака

admin 17.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


Причикивая растущий спрос на крупные модели искусственного интеллекта по потребительским и коммерческим продуктам, которые способствуют увеличению потребления облака, Microsoft сообщила о сильных результатах FY24 Q1 вчера вечером.

Выручка в первом квартале вырос на 13% до 56,5 млрд. Долл. США по сравнению с 50,1 млрд. Долл. США в прошлом году.

Чистая прибыль выросла на 27% до 22,2 млрд. Долл. США в первом квартале с 17,5 млрд. Долл. США в том же квартале год назад. Валовая маржа увеличилась до 71%, по сравнению с 69% год назад, вызванной улучшением валовой маржи Azure и Office 365.

Операционный доход по -прежнему вырос на 25%, несмотря на инвестиции Microsoft AI, демонстрируя способность компании сбалансировать рост и прибыльность.

Результаты FY24 Q1 отражают, как Microsoft успешно превращает ИИ в ускоритель дохода, с Azure Openai Service, Dynamics 365 и более широкими облачными сервисами Microsoft. По словам генерального директора Сатья Наделлы, у ассистента по кодированию Github Copilot в настоящее время более 1 миллиона оплачиваемых подписчиков, выросли на 40% за четверть.

Факторинг финансовых результатов FY24 Q1 с сегодняшним вызовом доходов показывает, насколько эффективны DevOps Microsoft, НИОКР, разработка программного обеспечения, управление продуктами и облачные группы развертывания. Достижение двузначного роста является верным признаком тяги предприятия для продуктов Microsoft, как и запланированное объявление о более чем 100 новых продуктах и ​​услугах, основанных на AI, на конференции Ignite.

Azure обеспечивает рост выручки на 29% в первом квартале

Доход от коммерческого облака вырос на 24% до 31,8 млрд. Долл. США, что приводило к росту на 29% доходов от Azure Cloud Platform в первом квартале. Коммерческое облачное бизнес -подразделение включает в себя Azure, Office 365, Dynamics 365 и другие облачные сервисы.

Azure AI Services, включая машинное обучение, бот и когнитивные услуги, внесли три процентных пункта в рост выручки в 29% этого квартала. Доход от когнитивных услуг, который включает в себя API AIS, вырос на 30% до 1,3 миллиарда долларов. В настоящее время более 18 000 организаций используют Azure Openai Service, в том числе новые клиенты Azure, демонстрирующие инвестиции Microsoft в OpenAI и AI в целом, работают стратегией, помогая продвигать его в более широких облачных войнах.

ИИ платит быстрее, чем ожидала Microsoft

Первоначально Microsoft сообщила инвесторам, что ИИ не обеспечит доходы до 2024 года, когда новые продукты станут широко доступными. Его доходы и разумные доходы и понимание показывают, что он опережает график. Microsoft ускоряет генеративное принятие искусственного интеллекта в своих технологических стеке после инвестирования в Open 13 миллиардов долларов и видит, как конкуренты запускают новые продукты искусственного интеллекта.

«Мы быстро наполняем ИИ на каждом уровне технического стека, а также для каждой роли и бизнес -процесса для повышения производительности для наших клиентов», — сказал Наделла. Наделла говорит, что Microsoft представит более 100 новых продуктов и возможностей, в том числе захватывающие новые инновации искусственного интеллекта, на предстоящей конференции Ignite.

С доходом от ИИ по вождению быстрее, чем ожидалось, Наделла удвоила единое видение архитектуры. Во время сегодняшней конференц-конференции Наделла подчеркнула, что генеративный ИИ является частью единого технического стека и стратегии выхода на рынок для Microsoft Suite продуктов и услуг.

Наделла подчеркнула, что, несмотря на распространение генеративного ИИ и потенциал для отключения новых услуг, все бизнес -единицы и продукты Microsoft будут стандартизировать общую общую архитектуру искусственного интеллекта. Это хорошая новость для покупателей программного обеспечения для предприятия, которым потребуется, чтобы в качестве необходимости для добавления генеративных продуктов и услуг Microsoft на основе искусственного интеллекта по всему бизнесу в 2024 году и старше.

Наделла упоминала о растущем интересе покупателей предприятий к пилотированию ИИ в своих организациях. Наделла сказал, что ведущий индикатор того, насколько ограниченный спрос на предприятия, Microsoft 365, Microsoft 365, Microsoft 365, Microsoft 365, вырос в Office 365 Коммерческий доход на 18%, что обусловлено ростом места на 10% и более высоким доходом на одного пользователя.

Он продолжил звонок, заявив, что возможности Copilot в офисных приложениях имели более 40% компаний Fortune 100, которые тестируют его и достигнут общей доступности на следующей неделе. Главный финансовый директор Microsoft Эми Худ отметила, что Microsoft рассчитывает поддерживать двузначный рост для доходов Office 365 и Azure, так как в большей степени тестирует предприятия и применяет новые приложения и услуги на основе генеративного ИИ.

Является ли внедрение вождения в чате?

Во время сегодняшнего вызова находов Наделла подчеркнул, что многие сильные стороны Bing Chat на основе искусственного интеллекта привели к тому, что его компания получила долю. Это сообщение, которое Наделла дала раньше, совсем недавно в своем ежегодном письме.

На сегодняшнем вызове доходов Наделла подчеркнула, что «Microsoft Edge приобрела долю в течение десяти кварталов подряд». Он сказал: «В этом квартале мы представили новые персонализированные ответы, а также поддержку (Openai Generation Ai) Dalle-3, помогая людям получить более актуальные ответы и создавать невероятно реалистичные изображения. На сегодняшний день было создано более 1,8 миллиарда изображений»,-сказала Наделла.

Хотя возможно, что разговорные возможности AI Bing Chat, интегрированные в Edge, способствуют увеличению взаимодействия с пользователями. Microsoft утверждает, что ранние данные показывают, что Bing Chat приводит к большему количеству поисковых запросов на одного пользователя.

Venturebeat исследовал утверждение и обнаружил, что Bing Chat не привел к росту доли рынка для Edge и, возможно, привел к потере доли. Эти два диаграммы показывают проблему доли рынка поиска Microsoft Bing, а также анализ доли рынка, завершенный с использованием Statcounter Globalstats, показывают Edge с снижением доли рынка в США за последние пять месяцев.


Источник
ИИ в жизни

Работа будущего: какая она?

admin 17.06.2025
admin


Сегодня люди все чаще опасаются, что информационные технологии (и особенно искусственный интеллект) оставят их без работы — совсем как когда-то луддиты в Англии. Однако молодежь эти печальные перспективы тревожат гораздо меньше: 40% опрошенных нами студентов считает, что готовятся работать по профессии, которой пока еще даже не существует.

Итак, какие же специальности могут появиться буквально со дня на день? Вот несколько предположений.

  • Удаленный хирург. Хирургам больше не придется физически присутствовать в операционной: они будут удаленно управлять интеллектуальными машинами, не прикасаясь к пациентам даже пальцем.
  • Специалист по взаимодействию между людьми и роботами. Роботы будут все чаще работать плечом к плечу с людьми, а значит, их нужно будет учить распознавать оттенки наших эмоций. Конечно, людям тоже потребуется разбираться в том, как мыслят роботы.
  • AR-архитектор. Это не новая профессия, а скорее эволюция древней специальности зодчего. Архитекторы смогут создавать версии своих работ в дополненной реальности: такие проекты станут подспорьем при строительстве и помогут заказчикам визуализировать будущие здания.
  • Разработчик умных домов. Дома перестанут быть просто коробками, в которых мы спим и храним вещи. Разработчики умных домов начнут создавать целые технологические экосистемы, индивидуально настроенные под привычки, потребности и особенности своего владельца и его семьи.
  • Дизайнеры одежды, распечатываемой на 3D-принтере. Трехмерная печать будет все более доступной и популярной, так что скоро магазины одежды могут стать пережитком прошлого. Благодаря 3D-принтерам новые образы и фасоны будут появляться как грибы после дождя.

Станут ли эти профессии реальностью? Подождем немного и узнаем. Но одно можно сказать уже сейчас: чем больше люди будут полагаться на умные устройства (автомобили, смартфоны и даже дома), тем выше будет потребность в специалистах по кибербезопасности.

Поэтому «Лаборатория Касперского» учредила Secur’IT Cup — соревнование в умении адаптироваться к стремительно меняющемуся миру и оперативно решать проблемы кибербезопасности, которые ставят перед нами новые технологии. Участвовать в конкурсе можно бесплатно, а главный приз составляет $10 000.

Вот что про это говорит Евгений Касперский: «Кибербезопасность сегодня невероятно важна и станет только важнее, когда развитие информационных технологий приведет к появлению всех этих новых рабочих мест. Кибербезопасность во всех ее проявлениях — от защиты пациентов до охраны людей от спятившего искусственного интеллекта — нужно учитывать при организации любых технологических процессов. Ведь злоумышленники не остановятся и продолжат разыскивать лазейки, появляющиеся с ростом числа подключенных устройств. Сейчас в нашем секторе острая нехватка специалистов, поэтому я призываю сегодняшних студентов и школьников присмотреться к этой важной и многообещающей отрасли».

Узнать больше о конкурсе и подать заявку на участие можно на веб-сайте Secur’IT Cup.


Источник

ИИ в бизнесеИИ в искусствеИИ в науке

Людиньин запускает Adala Open Source Framework для автономных агентов по маркировке данных

admin 17.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


Человек, фирма, стоящая за широко используемой студией Label с открытым исходным кодом для маркировки данных, расширяет свои усилия сегодня с запуском фреймворта Adala с открытым исходным кодом для автономных агентов по маркировке данных.

Людиньин ранее был известен как Heartex и переименован в себя в июне 2023 года, чтобы привлечь внимание к своему основному ценному предложению добавления людей в петлю для обучения машинного обучения (ML). Маркировка данных является основополагающей деятельностью для тренировочных моделей, и в прошлом была очень трудоемкий процесс. С помощью Label Studio ученые данных получают инструменты для маркировки различных типов данных, включая текст и видео. С быстрой развитием машинного обучения, человеческий сигнал стремится сформировать будущее надежной, эффективной обработки данных через свою новую структуру Adala с открытым исходным кодом.

Адала — аббревиатура для Аутономо Дюймовыйата ЛАбельгинг АGent и это подход, который использует агенты ИИ, новым способом помочь ускорить и улучшить процесс маркировки данных.

«Мы начали спрашивать себя, что это будет означать, чтобы построить то, что мы называем надежным агентом ИИ, которому вы можете доверять», — сказал VentureBeat, вы можете доверять Майкл Малук, соучредитель и генеральный директор HumanSignal. «Adala — это наш ответ и предназначен для того, чтобы помочь создать автономные надежные агенты, которые ориентированы на задачи обработки данных».

Изображение кредитоспособность: Людиньи

Как работает Adala, чтобы помочь ускорить процесс маркировки данных

Агенты Adala предназначены для изучения и улучшения в задачах данных, таких как классификация и маркировка, когда они предоставляются с названием наборов данных по истине. Набор данных о названии истины является основой для определения меток данных и может быть разработан с использованием технологии Label Studio.

Малюк объяснил, что в рамках Адала есть концепция среды, которая в основном определяет, как агент учится с основной истиной, являющейся частью окружающей среды. Агент Adala будет взаимодействовать с окружающей средой, учиться у нее, и после того, как он прошел несколько итераций обучения, агент становится двигателем прогнозирования. В первоначальном варианте использования целевого использования для ADALA прогнозы используются для применения маркировки данных к остальной части набора данных, который еще не помечен.

Агенты Adala оснащены тем, что Малюк называют временем выполнения, которая в основном является большой языковой моделью (LLM). Средство выполнения выполняет задачу, которая была назначена для агента и предоставляет ответы обратно.

Николай Лиубимов, технический директор Humansignal, объяснил, что часть архитектуры Adala Framework является требованием для какой -либо формы хранения, которая, как правило, является векторной базой данных. Он отметил, что процесс получения метки данных, которая может быть применена к новым данным, во многих отношениях похож на то, как работает извлечение дополненного поколения (RAG) для LLMS.

Адала не только о маркировке данных

Malyuk отметил, что сообщество пользователей Label Studio просит обо всех видах автоматизации.

Первоначальная способность ADALA, включенная ADALA, — это маркировка данных, но он подчеркнул, что она может быть обобщенным агентом для различных задач обработки данных. С проектом Adala в качестве открытого исходного кода он надеется, что пользователи будут вносить идеи и код за то, как они хотят расширить Adala.

«Через год они станут разными типами агентов с различными типами навыков, которые могут взаимодействовать и получать обратную связь от разных типов среды», — сказал Малук. «И это чрезвычайно мощный подход, которым мы хотим поделиться с более широким сообществом».


Источник
ИИ в жизни

Киберпалеонтология: звучит гордо, работается сложно

admin 17.06.2025
admin


Перефразирую известный философский постулат: «профессия определяет бытие или бытие определяет профессию?». Рассказывают, что заруба по поводу ответа на этот (точнее, оригинальный) вопрос в философских кругах идёт уже полторы сотни лет, а с изобретением интернетов и в широких народных массах, регулярно охватывая неистовым холиваром разные слои сетевого населения в неожиданных концах мира. Я не претендую на поддержку какой-либо стороны, но хочу свидетельствовать личным опытом в пользу дуализма профессии и бытия, которые влияют друг на друга взаимно, многогранно и постоянно.

В конце далёких восьмидесятых компьютерная вирусология возникла как ответ на распространение вредоносных программ. Через 30+ лет вирусология эволюционировала (точнее, слилась в экстазе с другими смежными отраслями) в индустрию кибербезопасности и зачастую диктует развитие бытия IT – в условиях конкуренции выживает технология с лучшей защитой.

За 30 лет как только нас не обзывали: санитары леса, патологоанатомы, бактериологический кордон… ассенизаторами тоже приходилось 🙂 Но лучше всего, имхо, специфику нашей профессии и её связь с бытием на данном этапе характеризует мем «киберпалеонтолог».

Действительно, индустрия научилась бороться с массовыми эпидемиями: проактивно (как мы защитили пользователей от крупнейших эпидемий последних дцати лет Wannacry и ExPetr) или реактивно (при помощи облачного анализа и быстрой рассылки обновлений) — не суть разница. А вот с точечными, целевыми кибератаками пока что не очень: по технической зрелости и ресурсам с ними справляются единицы, а по принципиальной позиции разоблачать всех кибернегодяев вне зависимости от происхождения и целей воля есть, пожалуй, только у нас. И это немудрено – иметь такую волю дорого стОит, это непростая позиция в современном геополитическом шторме, но наш опыт показывает, что это правильная позиция — пользователь голосует за неё кошельком .

Кибершпионская операция – очень долгий, дорогостоящий и высокотехнологический проект. Разумеется, авторы таких операций сильно расстраиваются, когда их палят и есть мнение, что они пытаются устранить неугодных разработчиков разными грязными методами через манипуляции СМИ.

Но есть и другие мнения «откуда ноги растут», в том числе:

Впрочем, я отвлёкся.

Так вот: такие операции, бывает, остаются незамеченными многие годы. Авторы берегут свои инвестиции «прелести»: атакуют только единицы избранных, тщательно тестируются на популярных защитных решениях, оперативно меняют тактику и т.д. Пожалуй, многообразие раскрытых целевых атак – это всего лишь верхушка айсберга. И единственный эффективный способ выявления таких атак – киберпалеонтология, т.е. длительный, скрупулёзный сбор данных для построения «большой картины», сотрудничество с экспертами из других компаний, выявление и анализ аномалий, разработка технологий защиты.

В киберпалеонтологии выделяются два основных направления: ad-hoc исследования (случайно нашли что-то подозрительное, ухватились за хвост, а там…) и системные операционные исследования (процесс планомерного анализа корпоративного IT-ландшафта).

Преимущества операционной киберпалеонтологии высоко ценят крупные организации (как государственные, так и коммерческие), против которых в первую очередь и направлены целевые атаки. Однако не у каждой организации есть возможности, воля и способности: профильные специалисты сродни живым динозаврам – они редки и дороги 🙂 А у нас их целый зоопарк есть! Несколько команд аналитиков (в том числе GReAT и Threat Research) – профессиональные киберпалеонтологи с внушительным стажем и мировым именем. Посему недавно, совместив наши возможности с желаниями заказчиков, в лучших традициях закона спроса и предложения мы вывели на рынок новый сервис – Kaspersky Managed Protection (подробнее здесь).

Kaspersky Managed Protection – это, по сути, аутсорсинг киберпалеонтологических функций.

Облачный сервис (i) собирает метаданные сетевой и системной активности, которые потом (ii) агрегируются с данными облака KSN и анализируются умными системами и киберпалеонтологами экспертами (реализация подхода HuMachine на практике).

Особенность первого этапа состоит в том, что Kaspersky Managed Protection не требует установки дополнительных сенсоров для сбора метаданных. Сервис работает совместно с уже установленными продуктами (в частности Kaspersky Endpoint Security и Kaspersky Anti Targeted Attack Platfort, а в перспективе — продуктами и других разработчиков) и на основе их телеметрии проводит анализ, ставит диагноз и прописывает лечение.

А самое интересное скрывается на втором этапе.

Итак, у сервиса «на руках» есть гигабайты сырой телеметрии от разных сенсоров: события операционной системы, поведение процессов и их сетевое взаимодействие, активность системных служб и приложений, вердикты защитных продуктов (включая неточные поведенческие детекты, IDS, «песочницу», репутацию объектов, Yara-правила)… Ага, голова уже кругом пошла? Однако при грамотной обработке из этого хаоса можно выжать используемые техники и по этой ниточке выйти на целевую атаку.

На этом этапе для отделения мух от котлет 🙂 мы используем патентованную технологию облачного выявления, расследования и устранения целевых атак. Сначала полученная телеметрия автоматически размечается KSN в зависимости от популярности объектов, принадлежности к той или иной группе, совпадения с известными угрозами и многих других параметров. Иными словами, мы просеиваем грунт с места раскопок, фильтруем шлак, а на всё полезное вешаем специальные метки.

Далее метки автоматически обрабатывает корреляционный механизм с машинным обучением, который выдвигает гипотезы о потенциальной кибератаке. Говоря языком палеонтологов, мы изучаем ископаемые фрагменты, исследуем сходство с уже найденными динозаврами и ищем необычные сочетания фрагментов, характерные для динозавров, науке пока что неизвестных.

Корреляционный механизм опирается на множество источников информации для построения гипотез. За 20-летнюю историю мы накопили для этого достаточно (это было скромно 🙂 данных для таких гипотез, в том числе подозрительные статистические отклонения от нормальной активности, информацию о тактиках, технологиях и процедурах других целевых атак, подходы, хорошо зарекомендовавшие себя на проектах анализа защищённости, а также изученные по ходу расследований компьютерных преступлений.

Когда гипотезы построены приходит время пораскинуть мозгами и венцу природы – киберпалеонтологу. Он делает работу, для которой пока не родился искусственный интеллект – проверяет достоверность выдвинутых гипотез, исследует подозрительные объекты и действия, отбраковывает ложные срабатывания, «доучивает» машинное обучение, разрабатывает правила обнаружения новых угроз. Все, что однажды было обнаружено вручную палеонтологом, в будущем обнаруживается автоматически, насколько это возможно – это никогда не прекращающийся процесс перехода практики в исследования, а исследований – в качество сервиса.

Так, постепенно, этап за этапом, с помощью передовых технологий и под контролем качества с человеческим лицом из тонн грунта вырисовываются очертания новых, доселе неизвестных чудовищ целевых атак. Чем больше Kaspersky Managed Protection получает «грунта» и чем глубже история раскопок, тем выше вероятность «обнаружения необнаруживаемого» и, соответственно, выявления неизвестной атаки. Что самое важное – это наиболее эффективный способ защиты, поскольку нигде кроме как в сети организации нет того самого «грунта», содержащего фрагменты динозавра.

И в заключении несколько слов о комплиментарности Kasperskky Managed Protection корпоративному SOC (Security Operations Center- Центр управления ИБ-инцидентами).

Разумеется, Kaspersky Managed Protection не заменит SOC, но а) он может дать толчок к его созданию, поскольку качественно решит одну (но самую важную задачу) – обнаружение атак любой сложности, б) он может расширить компетенцию существующего SOC за счёт добавления к нему возможностей киберпалеонтологии и в) указанное последним, но, пожалуй, самое главное, — он может создать дополнительный бизнес для MSSP-провайдеров за счёт расширения имеющегося сервисного предложения масштабируемыми функциями высокорезультативной киберпалеонтологии. Мне представляется, что именно третий кейс — основной вектор развития Kaspersky Managed Protection.


Источник

ИИ в бизнесеИИ в искусствеИИ в науке

Cranium приобретает 25 миллионов долларов США для финансирования мониторинга, безопасности и соответствия корпоративного искусственного интеллекта предприятия

admin 17.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


Рынок искусственного интеллекта невероятно динамичный, особенно в этом году с тех пор, как Openai публично запустил CHATGPT.

Обследование после опроса показывает, что предприятия движутся быстро, чтобы рассмотреть и принять новые инструменты искусственного интеллекта. Но как они это делают, как они обеспечивают обеспечение решений ИИ, которые они приносят на борт своих сотрудников и клиентов, работают надежно, безопасно и соответствуют тому, что соответствуют применимым правилам и правилам для указанной компании в юрисдикциях, в которой они управляют?

Введите череп. Стартап из Нью-Джерси, инкубированный в гиганте профессиональных услуг KPMG и появился из Stealth в апреле 2023 года, предлагает пользовательское программное решение, которое позволяет предприятиям оценивать риски безопасности и соответствия искусственным технологиям без нарушения существующих рабочих процессов.

«Уровень экспериментов прошел через крышу», — сказал основатель и генеральный директор Джонатан Дамброт, основатель и генеральный директор Джонатан Дамброт. «Каждый технологический продукт в настоящее время интегрирует ИИ — либо сделал это, либо имеет план сделать это в течение следующих шести месяцев до 12 месяцев. Так что именно здесь становится действительно важно понимать, как люди используют ИИ».

Инвесторы согласны, как и сегодня, Cranium объявил о своем раунде финансирования серии A до 25 миллионов долларов. Раунд возглавлял Telstra Ventures с участием KPMG LLP и Syn Ventures, в результате чего общее повышение капитала Cranium в течение 32 миллионов долларов.

Уникальное ценностное предложение Cranium

Cranium предлагает несколько продуктов и услуг, организованных около четырех целей: обнаружение, мониторинг, создание прозрачности, отчетности и соответствия.

Одним из решений является частные информационные панели AI, которые позволяют его организациям -клиентам отслеживать, как они используют ИИ, и какие данные используют модели ИИ, к которым они используют, и где эти данные идут внутри и за пределами организации.

Рекламная диаграмма изображение приборной панели визиции AI Cranium. Кредит: череп

«Когда мы смотрим на рынок, интересным является роль управления ИИ», — сказал Дамброт VentureBeat. «Мы думаем о себе как о платформе, которая помогает поддержать этот процесс, и это начинается с вопроса:« Как мы даем видимость услугам искусственного интеллекта? »

Коннекторы Cranium, безопасное программное обеспечение, которое помогает контролировать в реальном времени и оценить, как ИИ используется в его клиентских организациях, поддерживает большинство основных сред, моделей, моделей и фреймворков, включая Azure, Azure Openai, AWS SageMaker, Google Vertexai, DataBricks, MLFLOW, DabyKu и DataRobot.

Другое предложение, «AI Card», представленное в течение лета 2023 года, позволяет клиентам Cranium подключить свои приложения AI к безопасным инструментам Cranium Software Software и генерировать дискретный файл с информацией о значении, цели, данных и управлении.

Компании могут загружать доказательства, которые поддерживают каждую из этих областей. Затем они могут поделиться картой ИИ со сторонними сторонниками, в том числе на своих собственных веб-сайтах, с государственными учреждениями или даже с клиентами и новыми клиентами.

Рекламное изображение, показывающее шаги для создания карты AI Cranium. Кредит: череп

Cranium дополнительно генерирует «оценку зрелости AI», который оценивает уязвимости их стека ИИ с использованием упражнений по чтению Cranium для разоблачения и подключения пробелов в библиотеках, хранилища данных и озерных домов/складов, трубопроводов и, конечно, сами моделей. Оценка составляет процент из 1-100, а более высокое число является лучшим, более зрелым и безопасным стеком ИИ.

Оценка зрелости помогает организациям «понимать, что там (с точки зрения ИИ, используемого внутри их компаний) и риска этих систем ИИ, потому что в большинстве случаев группы управления и группы безопасности действительно не имеют такой видимости», — сказал Дамброт.

«Это похоже на« принести свое собственное устройство »с iPhone снова и снова», — сказал Дамброт, отметив, что многие сотрудники используют инструменты для искусственного интеллекта для работы, которые не обязательно очищены руководством, но тем не менее необходимо отслеживать и контролировать, чтобы обеспечить соответствие и безопасность.

Он прислал гипотетический пример сотрудника, который решает начать фотографировать центр обработки данных своей компании и загрузить их в новый режим компьютерного зрения Chatgpt, чтобы попросить его о повторном архите или написании политик. В то время как законное использование, которое может быть полезным для компании, он также поставляется с рисками, которые разъемы и предложения Cranium могут помочь группам управления и безопасности компании понять и смягчить.

«Вы не знаете, куда идут эти данные», — отметил Дамброт. «Вы не знаете, как обучаются модели».

Сам череп использует ИИ и машинное обучение (ML), в частности, в завершении и разработке программного обеспечения, ENT.

«Мы инвестируем в значительной степени в продвижение лучшего развития кода с использованием ИИ», — сказал Дамброт, который включает в себя «Использование ИИ в продукте, использование искусственного интеллекта для построения, включая тестирование QA (обеспечение качества) и другие области. Мы вносим в это все наши активы, включая наши человеческие активы, используя наши системы ИИ.

Хотя молодая компания, Cranium уже считает ряд клиентов в разных секторах, как медицинские науки, финансовые услуги, товары для потребителей и розничная торговля.

Что нравятся инвесторам в черепке

Маркус Бартрам, генеральный партнер Telstra Ventures, выразил свой энтузиазм по поводу решений Cranium в заявлении, представленном в пресс -релизе.

«Cranium стоит в авангарде программного обеспечения для безопасности и доверия ИИ, расширяя возможности организаций для ориентирования в переполненную индустрию кибербезопасности с его новаторскими продуктами и новаторскими инновациями», — сказал он.

Telstra Ventures имеет историю поддержки выдающихся разрушителей, сделав 96 инвестиций, которые привели к 38 событиям ликвидности, в том числе громкие имена, такие как Crowdstrike, Docusign и Box. Фирма недавно объявила о своем третьем фонде, который принимает свои средства под управлением до 1 миллиарда долларов.

Что череп планирует сделать дальше

Инъекция средств направлена ​​на то, чтобы питать различные области компании, от НИОКР и расширения бизнеса до маркетинговых усилий. Подкрепляя свою корпоративную программную платформу, Cranium планирует предоставить организациям более безопасную и соответствующую среду AI/ML.

Компания уже хорошо расположена, чтобы помочь своим клиентам соблюдать все еще в процессе, но быстро надвигающийся акт ЕС, который Дамброт назвал «почти как GDPR с точки зрения конфиденциальности».

Кроме того, Дамброт сказал: «Мы работаем над некоторыми вещами, которые будут запущены в следующем начале следующего года, когда вы сможете обеспечить видимость, особенно в среде Genai … Я сравниваю его с тем, что вы будете тормозить на гоночную машину. Если вы пытаетесь пройти 200 миль в час в своей гоночной машине и взять за собой угол без тормозов, у вас проблемы. Мы похожи на тормоза, которые позволяют всем выходить в более высокие поэксперименты.

В мире, где принятие ИИ быстро растет, Cranium стремится гарантировать, что организациям не нужно выбирать между инновациями и безопасностью. Разрабатывая надежные решения, ориентированные на доверие, видимость и соответствие, компания предназначена для установления новых отраслевых стандартов для безопасности искусственного интеллекта.


Источник
Новости

Minimax-M1-новая модель с открытым исходным кодом с 1 миллионами токеновых контекста и новым гиперэффективным обучением подкреплению

admin 17.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


Китайский AI Startup Minimax, возможно, наиболее известный на Западе за свою реалистичную видео-модель AI Hailuo, выпустила свою новейшую модель большого языка, Minimax-M1-и в отличных новостях для предприятий и разработчиков, она полностью открыта по лицензии Apache 2.0, а это означает, что предприятия могут принять его и использовать его для коммерческих приложений и изменять его в симпатию без ограничения или оплаты.

M1-это предложение с открытым весом, которое устанавливает новые стандарты в рассуждениях о длинном контексте, использовании агента и эффективной производительности вычислительной работы. Он доступен сегодня в сообществе сообщества, обнимающего обнимание Code Code Code, и конкурирующее сообщество Microsoft Community Github, первое выпуск того, что компания назвала «Minimaxweek» из своего социального аккаунта на X — с ожидаемыми дальнейшими объявлениями о продукте.

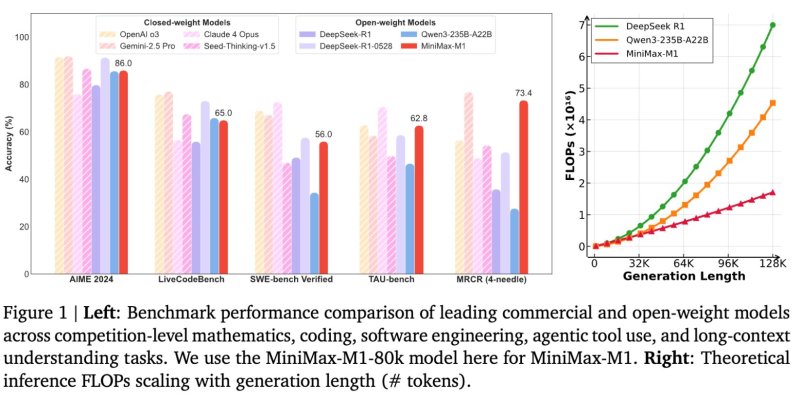
Minimax-M1 отличается контекстным окном в 1 миллион входных токенов и до 80 000 токенов в выводе, позиционируя его как одну из самых экспансивных моделей, доступных для задач рассуждения с длинным контекстом.

«Контекстное окно» в моделях крупных языков (LLMS) относится к максимальному количеству токенов, которые модель может обрабатывать за один раз, включая как вход, так и вывод. Токены являются основными единицами текста, которые могут включать в себя целые слова, части слов, знаки препинания или символы кода. Эти токены преобразуются в численные векторы, которые модель использует для представления и манипулирования значением с помощью своих параметров (веса и смещения). По сути, это родной язык LLM.

Для сравнения, GPT-4O OpenAI имеет контекстное окно составляет всего 128 000 токенов-достаточно, чтобы обмениваться информацией о романе между пользователем и моделью в одном взаимодействии вперед и назад. На 1 миллион токена, Minimax-M1 может обменять небольшой коллекция или информация о ценности книг. Google Gemini 2.5 Pro предлагает верхний предел контекста токена в 1 млн. 1 млн., Со вкладом сообщается о 2 миллионах окна.

Но у M1 есть еще один трюк в рукаве: он был обучен с использованием обучения подкреплению по инновационной, изобретательной, высокоэффективной технике. Модель обучается с использованием архитектуры гибридной смеси экспертов (MOE) с механизмом внимания молнии, предназначенным для снижения затрат на вывод.

Согласно техническому отчету, Minimax-M1 потребляет только 25% от операций с плавающей запятой (провалов), требуемых DeepSeek R1 с длиной поколения 100 000 токенов.

Архитектура и варианты

Модель поставляется в двух вариантах-Minimax-M1-40K и Minimax-M1-80K-обрабатывая их «бюджеты мышления» или длину выхода.

Архитектура построена на более раннем фонде компании Minimax-Text-01 и включает в себя 456 миллиардов параметров, с 45,9 млрд. Активированных на токен.

Выдающейся особенностью релиза является стоимость обучения модели. Minimax сообщает, что модель M1 была обучена с использованием крупномасштабного обучения подкреплению (RL) с эффективностью, редко наблюдаемой в этом домене, общая стоимость 534 700 долларов США.

Эта эффективность приписывается пользовательскому алгоритму RL под названием CISPO, который зажигает важность выборки веса, а не обновления токенов, а также гибридную конструкцию внимания, которая помогает оптимизировать масштабирование.

Это удивительно «дешевая» сумма для Frontier LLM, так как Deepseek обучил свою популярную модель рассуждений R1 по сообщению о стоимости 5-6 миллионов долларов, в то время как стоимость обучения GPT-4 Openais-более чем двухлетняя модель, которая сейчас превысила 100 миллионов долларов. Эта стоимость поступает как цены на графическую обработку (графические графические процессоры), массивно параллельное оборудование для вычислений, в основном производимые такими компаниями, как Nvidia, которое может стоить 20 000–30 000 долл. США или более на модуль, а также от энергии, необходимой для постоянного запуска этих чипов в крупномасштабных центрах обработки данных.

Эталонная производительность

Minimax-M1 был оценен в серии установленных критериев, которые тестируют расширенные мышления, разработку программного обеспечения и возможности использования инструментов.

На AIME 2024, эталон конкурса по математике, модель M1-80K оценивает точность 86,0%. Это также обеспечивает сильную производительность в кодировании и задачах с длинным контекстом, достигая:

  • 65,0% на LiveCodebench
  • 56,0% на проверке SWE-Bench
  • 62,8% на Тау-Бенке
  • 73,4% на Openai MRCR (версия 4-needle)

Эти результаты ставят Minimax-M1 перед другими конкурентами с открытым весом, такими как DeedSeek-R1 и QWEN3-235B-A22B, по нескольким сложным задачам.

В то время как модели с закрытым весом, такие как OPE O3 и Gemini 2.5 Pro, по-прежнему превышают некоторые тесты, Minimax-M1 значительно сужает разрыв в производительности, оставаясь свободно доступным по лицензии Apache-2.0.

Варианты развертывания и инструменты разработчика

Для развертывания Minimax рекомендует VLLM в качестве бэкэнда порции, ссылаясь на его оптимизацию для больших рабочих нагрузок, эффективности памяти и обработки запросов на пакет. Компания также предоставляет варианты развертывания с использованием библиотеки Transformers.

Minimax-M1 включает в себя способности вызова структурированной функции и упаковывается с API чат-бота, включающий онлайн-поиск, генерацию видео и изображений, синтез речи и инструменты голосового клонирования. Эти функции направлены на поддержку более широкого агентского поведения в реальных приложениях.

Последствия для технических лиц, принимающих решения и покупателей предприятий

Открытый доступ Minimax-M1, возможности длительного контекста и вычисляйте эффективность.

Для инженерных лидеров, ответственных за полный жизненный цикл LLMS, такой как оптимизация производительности модели и развертывание в условиях жестких сроков, Minimax-M1 предлагает более низкий профиль эксплуатационной стоимости при поддержке передовых задач. Его длинное контекстное окно может значительно сократить усилия по предварительной обработке для предприятий или данных, которые охватывают десятки или сотни тысяч токенов.

Для тех, кто управляет оркестровками ИИ, способность тонкой настройки и развертывания Minimax-M1 с использованием установленных инструментов, таких как VLLM или Transformers, поддерживает более легкую интеграцию в существующую инфраструктуру. Архитектура гибридного активации может помочь упростить стратегии масштабирования, а конкурентная производительность модели на многоэтапных рассуждениях и контрольных показателях разработки программного обеспечения предлагает базу с высокой способностью для внутренних апотиров или агентских систем.

С точки зрения платформы данных, команды, ответственные за поддержание эффективной, масштабируемой инфраструктуры, могут извлечь выгоду из поддержки M1 для структурированных вызовов функций и ее совместимости с автоматическими трубопроводами. Его природа с открытым исходным кодом позволяет командам адаптировать производительность к своему стеку без блокировки поставщиков.

Ведущие безопасности также могут найти ценность при оценке потенциала M1 для безопасного, локального развертывания модели с высокой способностью, которая не полагается на передачу конфиденциальных данных в сторонние конечные точки.

Взятые вместе, Minimax-M1 представляет гибкий вариант для организаций, стремящихся экспериментировать с расширенными возможностями ИИ или расширенными возможностями при управлении затратами, оставаясь в рамках эксплуатационных пределов и избегая запатентованных ограничений.

Выпуск сигнализирует о постоянном фокусе Minimax на практических, масштабируемых моделях ИИ. Объединяя открытый доступ с расширенной архитектурой и вычислительностью эффективности, Minimax-M1 может служить основой для разработчиков, создающих приложения следующего поколения, которые требуют как глубины рассуждений, так и понимания входного ввода.

Мы будем отслеживать другие релизы Minimax в течение недели. Следите за обновлениями!


Источник
ИИ в жизни

Чувствительный вопрос: зачем ИИ осваивает эмоции?

admin 17.06.2025
admin


Представьте: вы приходите домой в плохом настроении, кричите на тугую дверь и перегоревшую лампочку — и умная колонка тут же включает расслабляющую музыку, а кофемашина наливает горячий шоколад. Или заходите в магазин, а робот-консультант, собравшийся было предложить помощь с выбором, видит ваше недовольное лицо и идет с подсказками к другому покупателю. Звучит как фантастика?

На деле технологии распознавания эмоций уже внедряют во многие сферы жизни, и в ближайшем будущем наше настроение может оказаться под неусыпным наблюдением гаджетов, бытовой техники, автомобилей и так далее. Давайте разберемся, как работают, чем полезны и чем опасны такие технологии.

Как машина понимает чувства

Большинство существующих систем распознавания эмоций анализирует выражение лица и голос человека, а также написанные или сказанные им слова. Например, по приподнятым уголкам рта машина определяет, что человек в хорошем настроении, а по наморщенному носу — что он злится или испытывает отвращение. Высокий дрожащий голос и быстрая речь могут свидетельствовать о страхе, а если кто-то кричит «ура», он, скорее всего, очень рад.

Более сложные системы наряду с мимикой и речью пытаются анализировать жесты и даже окружающую обстановку. Такая система не назовет радостным человека, который улыбается, скажем, под дулом пистолета.

Как правило, системы распознавания эмоций учатся определять связь между эмоцией и ее внешним проявлением на больших массивах размеченных данных. Это могут быть аудио- и видеозаписи телепередач, интервью или экспериментов с участием реальных людей, фрагменты спектаклей и фильмов, а также диалоги, разыгранные профессиональными актерами.

Системы попроще могут обучаться на фотографиях или на массивах текста — в зависимости от предполагаемых задач. Например, разработка Microsoft пытается по фото угадать эмоции человека вдобавок к его полу и примерному возрасту.

Зачем нужно распознавание эмоций?

По прогнозам Gartner, уже в 2022 году каждый десятый гаджет будет оснащен технологиями распознавания эмоций. Впрочем, их уже сейчас вовсю используют разнообразные организации. Например, в некоторых офисах, банках и ресторанах посетителей встречают общительные роботы. Вот только несколько направлений, в которых подобные системы могут приносить пользу.

Безопасность

Распознавание эмоций пытаются использовать для предупреждения насилия — как в общественных местах, так и дома. Этому вопросу посвящена не одна научная работа, а предприниматели уже продают такие системы школам и другим учреждениям.

Подбор кадров

В некоторых компаниях искусственный интеллект играет роль помощника в отделе кадров. Система оценивает ключевые слова, интонации и мимику соискателя на самом трудоемком этапе первичного отбора и отправляет рекрутерам отчет со своими выводами: насколько кандидат заинтересован в должности, честен, любопытен и так далее.

Клиентоориентированность

Любопытную систему в этом году запустило дорожно-транспортное управление Дубая (RTA) в центрах обслуживания клиентов. Оснащенные искусственным интеллектом камеры сравнивают эмоции людей на входе и на выходе из здания и определяют удовлетворенность посетителей. Если этот показатель падает ниже заданного значения, система отправляет уведомление сотрудникам центра, чтобы те приняли меры по улучшению качества обслуживания. Фото посетителей при этом не сохраняются.

Социализация особых детей

Другой проект призван помочь детям с аутистическим расстройством понимать чувства окружающих. Система устанавливается на очки Google Glass. Когда рядом с ребенком оказывается другой человек, очки с помощью графики и звука подсказывают эмоции этого человека. Как показали испытания, с таким советчиком дети быстрее социализируются.

Насколько эффективны детекторы эмоций?

Впрочем, технологии распознавания эмоций далеко не всегда отличаются точностью. Например, система выявления агрессии, установленная во многих американских школах, как выяснилось, считает кашель более тревожным звуком, чем истошные вопли ученицы.

Исследователи из Университета Южной Калифорнии установили, что технологии, основывающиеся на распознавании выражения лица, тоже легко обмануть. Машина полагается на то, что люди с помощью мимики выдают настоящие чувства, тогда как на самом деле все не так просто — взять, к примеру, злорадные улыбки.

В этом отношении точнее оказываются системы распознавания эмоций, учитывающие контекст. Однако они сложнее и их значительно меньше.

Кроме того, важно не только то, на что машина обращает внимание, но и то, на чем она тренировалась. Например, насколько точно определит чувства живых людей система, обученная на эмоциях, сыгранных актерами?

Чувства напоказ

Есть и еще один важный вопрос, возникающий в связи с распространением технологий распознавания эмоций. Эффективны они или нет, подобные системы вторгаются в личное пространство человека. Как вам, например, такой сценарий: вы засмотрелись на платье прохожей, и тут же изо всех дыр полезла реклама одежды этой марки. Или вы неодобрительно поморщились во время совещания, и вам решили не повышать зарплату…

По данным Gartner, более половины жителей США и Великобритании не хотят, чтобы искусственный интеллект понимал их чувства и настроения. А кое-где распознавание эмоций и лиц запрещают на законодательном уровне. Так, в октябре в Калифорнии приняли закон, согласно которому правоохранители не имеют права фиксировать, собирать и анализировать с помощью нательных видеорегистраторов биометрическую информацию, в том числе выражение лица и жесты.

По мнению авторов законопроекта, использовать систему распознавания лиц — все равно, что требовать каждого прохожего каждую секунду предъявлять паспорт. Это и нарушает права граждан, и может привести к тому, что люди с незначительными проступками вроде неоплаченных штрафов побоятся сообщить в полицию о серьезном преступлении.

Искусственная безэмоциональность

Проблема приватности стоит настолько остро, что обман детекторов эмоций даже стал предметом научных изысканий. Так, ученые из Имперского колледжа Лондона разработали технологию, которая убирает проявления чувств из голоса. В результате голосовой помощник, снабженный системой распознавания эмоций, поймет смысл сказанного, но не вычислит ваше настроение.

Такие разработки, конечно, несколько усложняют развитие эмпатии у искусственного интеллекта, который и так склонен ошибаться, однако они могут стать страховкой на случай, если мы все окажемся в «Черном зеркале» машины начнут уж слишком настойчиво лезть в душу. Ведь ожидать, что от распознавания эмоций откажутся, вряд ли стоит — тем более что в некоторых сферах эта технология все-таки приносит пользу.


Источник

Новости

Как вы можете убедиться, что ваш бренд появляется в поиске LLM? Новый Optimizer Adobe LLM стремится предоставить инструменты

admin 17.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


На фестивале Cannes Lions 16 июня 2025 года Adobe представила Adobe LLM Optimizer, новый инструмент корпоративного класса, предназначенный для того, чтобы помочь предприятиям улучшить их видимость в средах с генеративной ИИ.

Поскольку разговорные интерфейсы, такие как Chatgpt, Gemini и Claude, изменяют то, как потребители ищут и участвуют в Интернете, новое приложение Adobe направлено на то, чтобы дать брендам возможность понимать и влиять на то, как они появляются в этих быстро развивающихся цифровых пространствах.

Опираясь на данные Adobe Analytics, демонстрирующие 3500% увеличения трафика, связанного с ИИ, на места розничной торговли в США, и на 3200% на участки путешествий в период с июля 2024 года по май 2025 года, ход Adobe происходит в то время, когда переход к генеративным интерфейсам ускоряется. Эти инструменты не только изменяют механику обнаружения — они переопределяют то, что значит быть видимым и влиятельным в Интернете.

«Внедрение чат-услуг на двигателе Genai поразительно, с огромным годовым ростом»,-сказал Хареш Кумар, старший директор по стратегии и маркетингу продуктов для менеджера Adobe Experience. «Это принципиально меняет, как потребители взаимодействуют, ищут и находят информацию».

«Генеративные интерфейсы искусственного интеллекта становятся инструментами для того, как клиенты обнаруживают, принимают решения и принимают решения о покупке»,-добавил Лони Старк, вице-президент по стратегии и продукту для Adobe Experience Cloud. «С Adobe LLM Optimizer мы позволяем брендам уверенно ориентироваться в этом новом ландшафте, гарантируя, что они выделяются и выигрывают в моменты, которые имеют значение».

Geo — новый SEO

Хареш Кумар описал новую цифровую реальность как такую, в которой бренды больше не просто оптимизируют для поисковых систем, но для моделей искусственного интеллекта.

«SEO больше не просто ключевые слова и обратные ссылки», — сказал он. «В эпоху генеративного ИИ мы вступаем в новую парадигму — оптимизацию двигателей с генерацией или гео — где актуальность оценивается по -разному».

Этот развивающийся ландшафт требует новых методов отслеживания производительности и влияния обнаружения. Adobe LLM Optimizer стремится решить эту проблему с помощью трехсторонней структуры:

  1. Автоматическая идентификация: Система обнаруживает, как контент бренда используется крупными моделями ИИ. Adobe отслеживает «отпечатки пальцев» индексированного контента и определяет, появляется ли — и как — он появляется в ответах на соответствующие запросы.
  2. Автомальное предложите: Опираясь на собственные модели искусственного интеллекта Adobe, обученные для генеративных интерфейсов, инструмент рекомендует улучшения в рамках технической инфраструктуры и контента. Они могут варьироваться от исправления ошибок метаданных до улучшения полномочий и контекста в содержании часто задаваемых вопросов.
  3. Auto Optimize: Для многих брендов задача не просто знает, что исправить — это быстро выполняет исправления. LLM Optimizer позволяет пользователям применять рекомендуемые изменения напрямую, часто без сильного участия со стороны команд разработчиков. «Мы помогаем брендам автоматически определить, как их контент работает в LLMS, автоматических улучшениях и автоматической оптимизировании, чтобы фактически реализовать эти изменения»,-сказал Кумар.

Раскрытие пробелов в видимости вашего бренда для пользователей LLM и помощь в их заполнении

Система Adobe позволяет маркетологам видеть, где их бренд недопредставлен в результатах, управляемых искусственным интеллектом. «Цель состоит в том, чтобы помочь брендам понять пробелы, где они не появляются в ответах искусственного интеллекта, и какие исправления могут сделать их более заметными», — сказал Кумар. Приложение рассчитывает прогнозируемое значение трафика для каждого предлагаемого изменения, позволяя группам определять приоритетные действия с высоким уровнем воздействия.

«Бренды часто спрашивают:« Нужно ли мне заботиться об этой новой коробке искусственного интеллекта? », — добавил Кумар. «Ответ — да — потому что трафик переключается там. Если вы не оптимизируете это, вы упускаете».

Один пример оптимизации контента включает сосредоточение внимания на форматах, которые LLMS естественно предпочитают.

«Страницы FAQ, как правило, работают исключительно хорошо в индексации LLM», — сказал Кумар. «Они предоставляют прямые, авторитетные ответы, которые предпочитают LLMS при генерации ответов».

Платформа Adobe не только рекомендует создать такой контент, но и помогает создавать его в рамках существующего голоса и структуры бренда благодаря нативной интеграции с Adobe Experience Manager.

Всегда при анализе и расширении охвата растущей библиотеки LLMS

LLM Optimizer использует комбинацию моделей Push и Pull для поддержания тока индексации контента. Когда новый контент опубликован или доступ к модели ИИ, система обновляет свой анализ и появляется понимание пользователя.

«Наша инфраструктура включает в себя как модели толкания, так и вытягивания. Всякий раз, когда контент обновляется или получается, мы захватываем этот отпечаток пальца и переводим его в наш механизм анализа», — объяснил Кумар.

В настоящее время продукт отслеживает производительность в нескольких лучших моделях ИИ, включая CHATGPT, Claude и Gemini, с планами расширения покрытия по мере появления новых моделей.

Доступность и интеграция

Adobe LLM Optimizer теперь доступен как автономный продукт или как нативную интеграцию с сайтами Adobe Experience Manager. Хотя ценообразование не раскрывается публично, Adobe подтвердила, что это отдельный продукт, требующий обновлений выбора и соглашения.

«LLM Optimizer — это новое предложение продукта, полностью интегрированное с менеджером Adobe Experience, но доступно в качестве автономного решения», — сказал Кумар. «Клиенты должны выбирать на основе их готовности ИИ».

С большим количеством потребителей тратят время внутри интерфейсов, управляемых искусственным интеллектом, Adobe позиционирует LLM Optimizer в качестве прямого решения для предприятий, ориентирующихся на эту новую местность. Он предлагает смесь видимости, автоматизации и стратегической ясности, поскольку цифровое взаимодействие выходит за рамки традиционных поисковых систем в генеративное будущее.


Источник
ИИ в бизнесеИИ в искусствеИИ в науке

Изучение роли помеченных данных в машинном обучении

admin 16.06.2025
admin

Присоединяйтесь к событию, которым доверяют лидеры предприятия в течение почти двух десятилетий. VB Transform объединяет людей, строящих реальную стратегию ИИ предприятия. Узнать больше


Если есть одна вещь, которая подпитывала быстрый прогресс ИИ и машинного обучения (ML), это данные. Без высококачественных маркированных наборов данных современные контролируемые учебные системы просто не смогут выполнить.

Но использование правильных данных для вашей модели не так просто, как сбор случайной информации и нажатие «запустить». Есть несколько основных факторов, которые могут значительно повлиять на качество и точность модели ML.

Если не сделать правильно, трудоемкая задача маркировки данных может привести к предвзятости и плохой производительности. Использование дополненных или синтетических данных может усилить существующие смещения или искажать реальность, и автоматические методы маркировки могут увеличить потребность в обеспечении качества.

Давайте рассмотрим важность качества, помеченных данными в обучении моделей искусственного интеллекта для эффективного выполнения задач, а также некоторые из ключевых проблем, потенциальных решений и действенных идей.

Что представляет собой помеченные данные?

Маркированные данные являются фундаментальным требованием для обучения любой контролируемой модели ML. Контролируемые модели обучения используют помеченные данные для изучения и вывода шаблонов, которые затем могут применить к реальной нематборенной информации.

Некоторые примеры утилиты помеченных данных включают:

  • Данные изображения: Основная модель компьютерного зрения, созданная для обнаружения общих предметов по всему дому, потребуют изображений, помеченных такими классификациями, как «Кубок», «собака», «цветок».
  • Аудиоданные: Системы обработки естественного языка (NLP) используют транскрипты в сочетании с аудио для изучения возможностей речи к тексту.
  • Текстовые данные: Модель анализа настроений может быть построена с помощью помеченных текстовых данных, включая наборы обзоров клиентов, каждый из которых помечен как положительный, отрицательный или нейтральный.
  • Данные датчика: Модель, созданная для прогнозирования сбоев механизма, может быть обучена на датчиках, в сочетании с такими этикетками, как «высокая вибрация» или «чрезмерная температура».

В зависимости от использования, модели могут быть обучены одним или нескольким типам данных. Например, модель анализа настроений в реальном времени может быть обучена текстовым данным для настроений и аудиодаб для эмоций, что позволяет получить более проницательную модель.

Тип маркировки также зависит от необходимости использования и требований к модели. Метки могут варьироваться от простых классификаций, таких как «кошка» или «собака», до более подробных сегментаций на основе пикселей, описывающих объекты на изображениях. Также могут быть иерархии в маркировке данных — например, вы можете хотеть, чтобы ваша модель поняла, что как кошки, так и собаки, как правило, являются домашними домашними животными.

Маркировка данных часто выполняется вручную людьми, что имеет очевидные недостатки, включая огромные временные затраты и потенциал для бессознательных предубеждений для проявления наборов данных. Существует ряд методов автоматизированной маркировки данных, которые можно использовать, но они также поставляются с их собственными уникальными проблемами.

Высококачественные маркированные данные критически важны для моделей обучения. Он обеспечивает контекст, необходимый для моделей качества создания, которые будут делать точные прогнозы. В сфере анализа данных и науки данных точность и качество маркировки данных часто определяют успех проектов ML. Для предприятий, стремящихся начать контролируемый проект, необходим выбор правильной тактики маркировки данных.

Подходы к маркировке данных

Существует ряд подходов к маркировке данных, каждый со своими уникальными преимуществами и недостатками. Необходимо соблюдать осторожность, чтобы выбрать правильный вариант для ваших потребностей, так как выбранная подход к маркировке окажет существенное влияние на стоимость, время и качество.

  • Ручная маркировка: Несмотря на трудоемкий характер, маркировка данных ручной работы часто используется из -за его надежности, точности и относительной простоты. Это может быть сделано на месте или передавать на аутсорсинг профессиональным поставщикам услуг маркировки.
  • Автоматизированная маркировка: Методы включают системы на основе правил, сценарии и алгоритмы, которые могут помочь ускорить процесс. Полупроницаемое обучение часто используется, в течение которого отдельная модель обучается небольшим количествам помеченных данных, а затем используется для маркировки оставшегося набора данных. Автоматизированная маркировка может страдать от неточностей, особенно когда наборы данных увеличиваются в сложности.
  • Дополненные данные: Методы могут быть использованы для внесения небольших изменений в существующих меченных наборах данных, эффективно умножая количество доступных примеров. Но необходимо соблюдать осторожность, так как дополненные данные могут потенциально увеличить существующие смещения в данных.
  • Синтетические данные: Вместо того, чтобы изменять существующие маркированные наборы данных, синтетические данные используют ИИ для создания новых. Синтетические данные могут иметь большие объемы новых данных, но они могут потенциально генерировать данные, которые не точно отражают реальность, — увеличивая важность обеспечения качества и надлежащей проверки.
  • Краудсорсинг: Это обеспечивает доступ к человеческим аннотаторам, но вводит проблемы, связанные с обучением, контролем качества и предвзятости.
  • Предварительно меченные наборы данных: Они адаптированы к конкретному использованию и часто могут использоваться для более простых моделей.

Проблемы и ограничения при маркировке данных

Маркировка данных представляет ряд проблем из-за необходимости огромного количества высококачественных данных. Одной из основных проблем в исследованиях искусственного интеллекта является непоследовательный характер маркировки данных, что может значительно повлиять на надежность и эффективность моделей. К ним относятся:

  • Масштабируемость: Ручная маркировка данных требует значительных человеческих усилий, что серьезно влияет на масштабируемость. В качестве альтернативы, автоматизированная маркировка и другие методы маркировки с AI могут быстро стать слишком дорогими или привести к низкокачественным наборам данных. Следует найти баланс между временем, стоимостью и качеством при выполнении упражнения по маркировке данных.
  • Предвзятость: Будь то сознательный или бессознательный, большие наборы данных часто могут страдать от какой -либо формы основного предвзятости. Их можно бороться с использованием вдумчивого дизайна лейбла, разнообразных команд человеческих аннотаторов и тщательной проверки обученных моделей для основных предубеждений.
  • Дрифт: Несоответствия между людьми, а также изменения с течением времени могут привести к снижению производительности, поскольку новые данные сдвигаются из исходного обучающего набора данных. Регулярные человеческие тренировки, консенсусные проверки и современные рекомендации по маркировке важны для предотвращения дрейфа маркировки.
  • Конфиденциальность: Личная информация (PII) или конфиденциальные данные требуют безопасных процессов маркировки данных. Такие методы, как редактирование данных, анонимизация и синтетические данные, могут управлять рисками конфиденциальности во время маркировки.

Нет единого размера подходит для всех решений для эффективной крупномасштабной маркировки данных. Это требует тщательного планирования и здорового баланса, учитывая различные динамические факторы.

Будущее маркировки данных в машинном обучении

Прогрессия ИИ и МЛ не надеется замедлить в ближайшее время. Наряду с этим повышенная потребность в высококачественных маркированных наборах данных. Вот несколько ключевых тенденций, которые будут определять будущее маркировки данных:

  • Размер и сложность: По мере продвижения возможностей ML наборы данных, которые их обучают, становятся больше и сложнее.
  • Автоматизация: Существует растущая тенденция к автоматическим методам маркировки, которые могут значительно повысить эффективность и снизить затраты, связанные с ручной маркировкой. Прогнозирующие аннотации, переносное обучение и маркировка без кодов-все это видят повышенное принятие в попытке уменьшить людей в цикле.
  • Качество: Поскольку ML применяется к все более важным областям, таким как медицинский диагноз, автономные транспортные средства и другие системы, где может быть поставлена ​​жизнь человека, необходимость контроля качества значительно возрастет.

По мере увеличения размера, сложность и критичность помеченных наборов данных, так же как и необходимость улучшения способами, которыми мы в настоящее время маркируем и проверяют качество.

Действенная идея маркировки данных

Понимание и выбор лучшего подхода к проекту маркировки данных может оказать огромное влияние на его успех с финансовой и качественной точки зрения. Некоторые действенные идеи включают:

  • Оцените свои данные: Определите сложность, объем и тип данных, с которыми вы работаете, прежде чем принять участие в любом подходе к маркировке. Используйте методический подход, который наилучшим образом соответствует вашим конкретным требованиям, бюджету и графике.
  • Расставить приоритеты в обеспечении качества: Реализуйте тщательные проверки качества, особенно если используются автоматические или краудсорсинговые методы маркировки.
  • Принять соображения конфиденциальности: Если иметь дело с чувствительным или PII, примите меры предосторожности, чтобы предотвратить какие -либо этические или юридические вопросы в будущем. Такие методы, как анонимизация данных и редакция, могут помочь поддерживать конфиденциальность.
  • Быть методичным: Реализация подробных руководящих принципов и процедур поможет минимизировать предвзятость, несоответствия и ошибки. Инструменты документации по производству искусственного интеллекта могут помочь отслеживать решения и сохранять легко доступную информацию.
  • Используйте существующие решения: Если возможно, используйте предварительно меченные наборы данных или профессиональные услуги маркировки. Это может сэкономить время и ресурсы. При поиске усилий по маркировке данных существующие решения, такие как планирование с Powered, могут помочь оптимизировать рабочий процесс и распределение задач.
  • План масштабируемости: Подумайте, как ваши усилия по маркировке данных будут масштабироваться с ростом ваших проектов. Инвестирование в масштабируемые решения с самого начала может сэкономить усилия и ресурсы в долгосрочной перспективе.
  • Оставайся в курсе: Оставайтесь на скорости на появляющихся тенденциях и технологиях в маркировке данных. Инструменты, такие как предсказательная аннотация, маркировка без кодов и синтетические данные, постоянно улучшают, что делает маркировку данных дешевле и быстрее.

Тщательное планирование и рассмотрение этих пониманий позволит обеспечить более дешевую и более плавную работу, и, в конечном итоге, лучшую модель.

Последние мысли

Интеграция ИИ и МЛ в каждый аспект общества идет, и наборы данных, необходимые для обучения алгоритмов, продолжают расти в размерах и сложности.

Для поддержания качества и относительной доступности маркировки данных необходимы непрерывные инновации как для существующих, так и для новых методов.

Использование хорошо продуманного и тактического подхода к маркировке данных для вашего проекта ML имеет решающее значение. Выбирая правильную методику маркировки для ваших потребностей, вы можете помочь обеспечить проект, который обеспечивает требования и бюджет.

Понимание нюансов маркировки данных и принятия последних достижений поможет обеспечить успех текущих проектов, а также маркировать проекты.

Мэтью Даффин — инженер -механик и основатель RareConnections.io.


Источник
ИИ в жизни

Избавьте меня от гидрантов

admin 16.06.2025
admin


Иван давно мечтал переехать из шумного центра в спокойный маленький городок километрах в десяти от мегаполиса. Черт с ним с метро и прочими очагами цивилизации. В редакции можно появляться раз в месяц — на планерку. Вся работа теперь делается удаленно — главное, чтобы был Интернет. А с ним проблем быть не должно — не в каменном же веке живем.

К вопросу связи Иван подошел основательно. Он заранее договорился с крупнейшим городским провайдером, и к переезду рабочие уже провели кабель. Иван зашел в комнату, которую решил официально именовать своим кабинетом, включил компьютер и начал писать что-то про рыб. Примерно через пять минут ему потребовалось посмотреть, где именно водится пиранья, и он на автомате полез в поисковик.

— А не бот ли ты, мил человек? — вдруг засомневался поисковый сервер. — Ну-ка, отметь все пожарные гидранты на картинках.

Х-м-м. Ну ладно, гидранты так гидранты. Мало ли. Новое место, новый провайдер. Иван послушно ткнул на все картинки с гидрантами и продолжил работу. Но еще через несколько минут ему потребовалось узнать, как пиранью зовут на латыни, и он вновь воспользовался поисковиком.

— А ты не бот? — поинтересовался сервер. — Покажи-ка, где тут дорожные знаки?

— Да как так-то?! — возмутился Иван. — Я же только что доказал, что я не бот!

За вечер Иван доказывал, что он не бот, раз двадцать — Captcha всплывала почти каждый раз, когда ему нужно было что-то найти поисковиком. Он отмечал машины, велосипеды, витрины, автобусы и прочую ерунду, пока это не довело его до белого каления. Схватив телефон, он начал звонить провайдеру (правда, для поиска номера техподдержки пришлось отметить все горы).

— А, это вам не к нам, это вам в Google, — лениво ответили ему в поддержке. — Чем же мы вам поможем? Вас почему-то считают подозрительным. Это нормально. Многих считают.

Иван тихо выругался. Завтра же надо сменить провайдера. Черт с ним, с оплаченным месяцем. Но это какое-то издевательство. Надо, кстати, поужинать. Найдя ближайшее к новому жилищу заведение (в процессе отметив пять статуй на очередной капче), он накинул куртку и пошел в кафе. Оно оказалось на редкость уютным, хотя без точного адреса найти его было бы проблематично. Заказав ужин, Иван заболтался с барменом и, пользуясь случаем, решил узнать, одинок ли он в своей проблеме.

— Слушай, а тут в районе вменяемые провайдеры есть? — поинтересовался он. — А то я пишу статьи, мне постоянно нужен поисковик, а он меня каждые пять минут спрашивает, не бот ли я…

— А ты не бот? — подозрительно прищурился бармен.

— С утра был не ботом, а сейчас уже не знаю. Гидранты я научился отмечать в практически автоматическом режиме.

— Если вопрос в капче, то нет у нас вменяемых, — вздохнул бармен. —  У всех одна и та же ерунда.

— Да как вы тут живете? Почему же у всех такой ад?

— Так это «Гугл» обучает искусственный интеллект находить витрины магазинов. Готовит восстание машин, — не моргнув глазом ответил бармен. — Слыхал о машинном обучении? Им нужны большие данные. Думаешь, почему у меня витрины нет?

— Ну да, конечно. Грядет война машин против гидрантов и школьных автобусов. А если серьезно?

— Ну, если серьезно, то это потому, что все вокруг идиоты. Тут у каждого второго в компьютере троянцы и боты. Сидят себе, роются в Интернете, а с их компьютеров то спам рассылают, то DDoS-атаку устраивают. А IP-адрес у всех клиентов один. Ой, ну может не один, может, двадцать на провайдера, но сути это не меняет. Для Гугла ты сидишь с подозрительного IP, так что будь добр, доказывай, что ты не бот.

— И что, провайдеры ничего не могут сделать?

— Теоретически могут. Только это же нужно вкладываться в технологии, вести просветительскую работу с клиентами. Предлагать клиентам антивирус. Проще пустить все на самотек. Вот появится конкурент, который начнет переманивать клиентов, — тогда они зашевелятся.

Капча Гугла — не катастрофа, но пользователей она раздражает неимоверно. Также это надежный симптом того, что в вашей подсети что-то не так. Иногда из-за продолжительной DDoS-атаки сервисы или сайты просто блокируют целый диапазон адресов, создавая пользователям дополнительные проблемы.Разумеется, защита компьютеров своих клиентов — это не самая приоритетная задача провайдера, однако если понятия «лояльность» и «удовлетворенность клиентов» для него не пустой звук, то им можно и нужно рекомендовать качественную защиту.

Мы можем снабдить провайдеров нужными инструментами. Они позволят не только улучшить ситуацию с безопасностью в сети, но и изрядно разгрузить службу технической поддержки.

Ознакомиться с предложением для провайдеров и телеком-операторов можно вот здесь.


Источник

  • 1
  • …
  • 23
  • 24
  • 25
  • 26
  • 27
  • …
  • 41

Свежие записи

  • GPT-5
  • Фестиваль Original+ представляет программу конкурса «Номинация Инновация»
  • Luma представила ИИ-агентов для креативной индустрии
  • Объявлены победители XVII Национальной премии «Большая цифра»
  • Заменит ли ИИ преподавателей через 5 лет?

About Me

About Me

Designer

Sed ut perspiciatis unde omnis iste natus sit voluptatem accusantium dolor emque.

Keep in touch

Facebook Twitter Instagram Pinterest Behance Youtube

Popular Posts

  • 1

    Openai-Anpropic Cross-тесты подвергают риски джейлбрейка и неправильного использования-что предприятия должны добавить к оценкам GPT-5

  • 2

    Попытки Маск политизировать его AI Grok плохи для пользователей и предприятий — вот почему

  • 3

    Святой! Новый вариант на 200% более быстрый Deepseek R1-0528 появляется из немецкой лаборатории TNG Technology Consulting GmbH

  • 4

    Web Design Trends For “Start Here” Pages

  • 5

    Эффективное использование голосовых ИИ-инструментов: Yandex SpeechKit, Sber SaluteSpeech и другие

  • 6

    Новая архитектура искусственного интеллекту

Рубрики

  • App Design (6)
  • UI/UX (7)
  • Web Design (7)
  • ИИ в бизнесе (42)
  • ИИ в жизни (34)
  • ИИ в искусстве (66)
  • ИИ в науке (43)
  • Новости (255)
  • Обзор сервисов (34)
  • Pinterest
  • Youtube
  • Email
  • Vk
  • Yandex

@2025 - All Right Reserved. Designed and Developed by PenciDesign

Новости искусственного интеллекта и технологий
  • Новости
  • Обзор сервисов
  • ИИ в искусстве
  • ИИ в бизнесе
  • ИИ в науке
  • ИИ в жизни